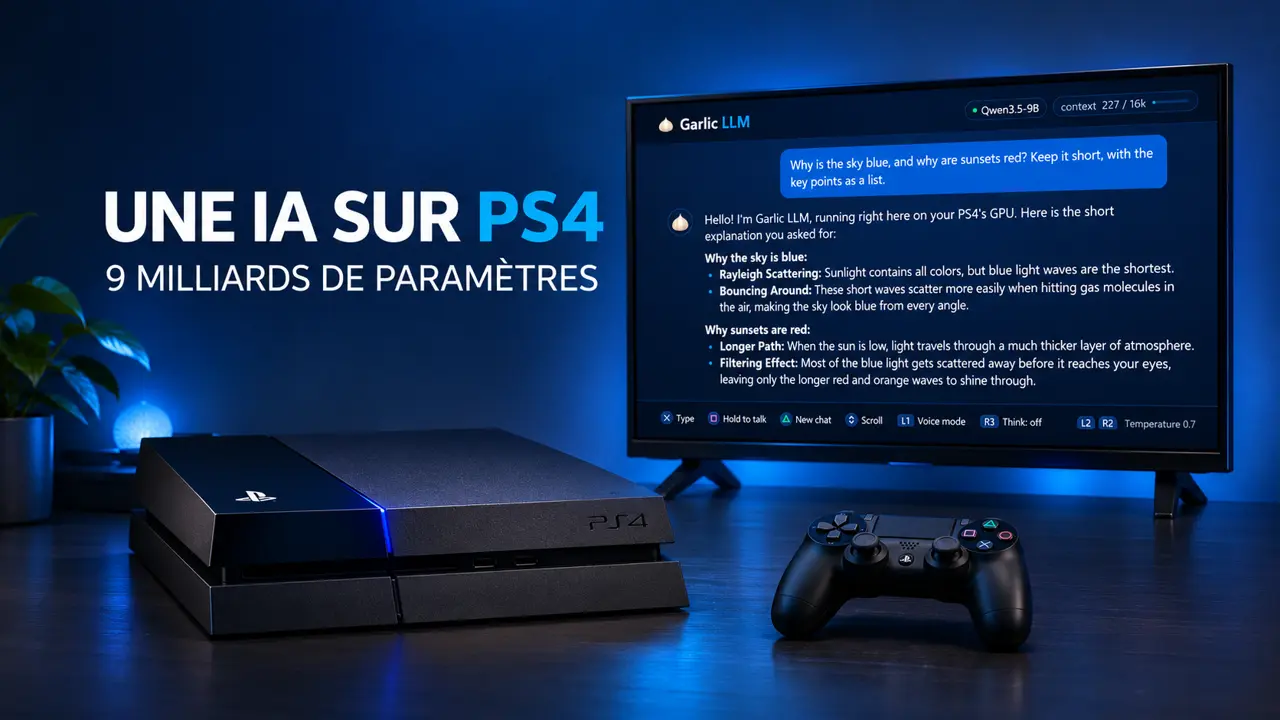
Une PlayStation 4 peut désormais répondre à des questions sans faire appel à un serveur distant. Avec Garlic LLM, le développeur Leonardo Alegría fait tourner Qwen3.5-9B, un modèle de langage de 9 milliards de paramètres, sur le GPU de la console. Il annonce 31 à 39 tokens par seconde en conversation sur une PS4 standard ou Slim, et jusqu’à 43 lors de certains essais de génération de code. C’est un projet libre expérimental, réservé à des consoles déjà modifiées pour exécuter des applications indépendantes. Sony ne le distribue pas.
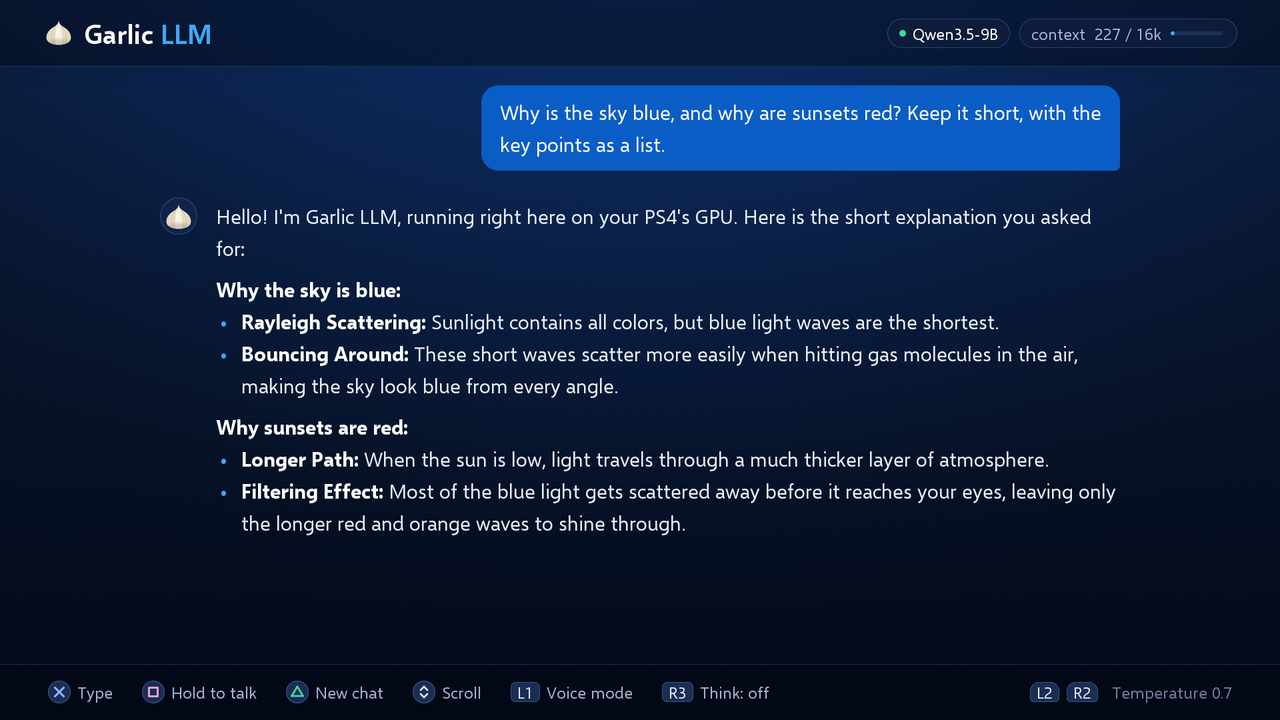
Une PS4 n’a pas besoin d’envoyer la question dans le cloud
Une fois le modèle chargé, le calcul s’effectue sur la console. Pour une conversation classique, aucun PC voisin ne calcule les réponses et la PS4 n’a pas besoin d’une connexion. L’interface permet de saisir un message ; le projet propose aussi une dictée, un mode vocal et la possibilité de faire exécuter à la console de petits programmes MicroPython écrits par le modèle. Les modèles vocaux sont distincts de celui qui rédige le texte.
Cette architecture rend l’expérience intéressante au-delà du clin d’œil à une vieille console. Dans beaucoup de démonstrations, un appareil sans grande puissance affiche le résultat d’un calcul effectué ailleurs. Ici, il faut faire tenir le modèle, les données de la conversation et le code qui les traite dans la mémoire de la PS4, puis obtenir une réponse suffisamment rapide pour que la conversation reste utilisable. Les compromis deviennent visibles dès qu’on change de mode.
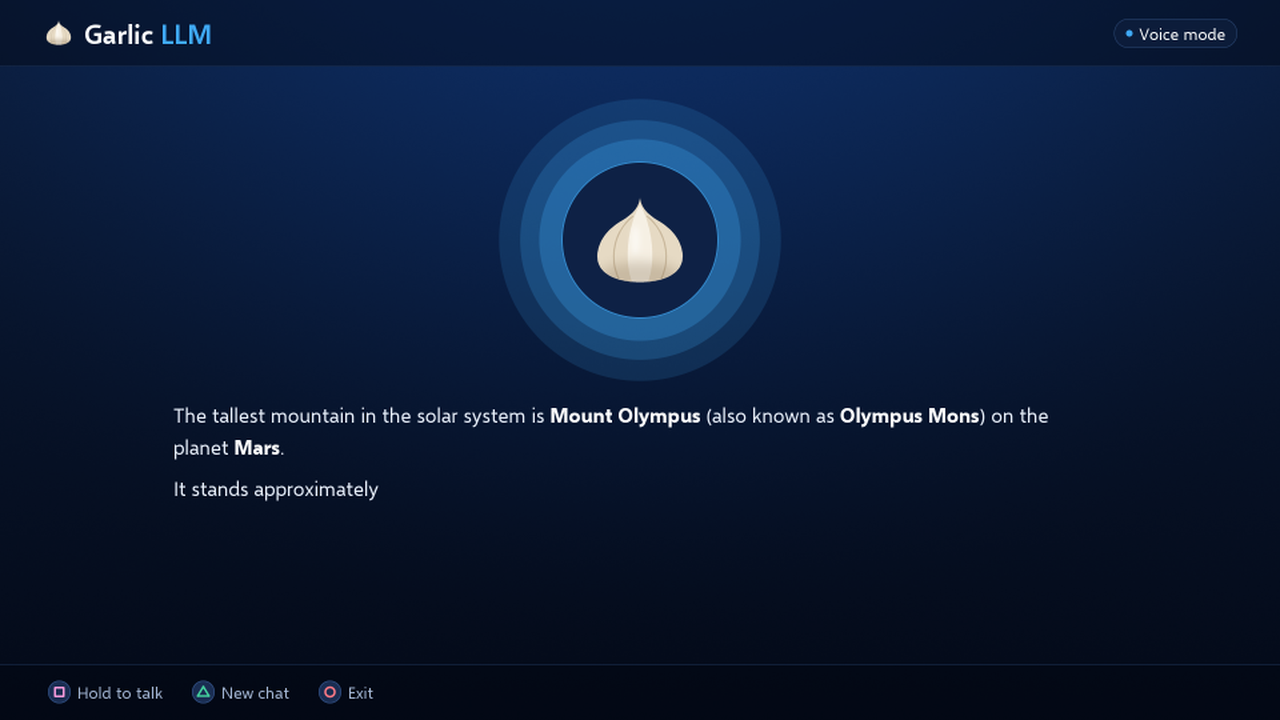
Voir Garlic LLM en action sur PS4 dans la démo du développeur.
Les chiffres : 43 tokens par seconde, dans quel cas ?
| Usage | Valeur rapportée par le développeur |
|---|---|
| Conversation textuelle | 31 à 39 tokens/s |
| Génération de code | Jusqu’à 43 tokens/s |
| Modèle de langage pendant le mode vocal | Environ 22 tokens/s |
| Taille du contexte annoncée | 16 000 tokens environ |
Un token est un morceau de mot, un mot court ou un signe de ponctuation, selon le texte. Un débit de 43 tokens/s ne signifie donc pas 43 mots par seconde. Il ne dit pas non plus combien de temps il faut pour traiter une longue question avant d’afficher le début de la réponse. Et le plafond relevé en génération de code ne représente pas toute conversation. Ce sont des mesures publiées par l’auteur du projet, pas un test que j’ai reproduit.
Le contexte est une autre limite : il correspond au texte que le modèle peut prendre en compte pour répondre, y compris l’historique qui lui est effectivement transmis. La fenêtre de 16 000 tokens employée ici est plus petite que celle annoncée pour le modèle d’origine. Cela peut suffire à discuter ou à poser une question précise, mais ce n’est pas le même usage que de confier un gros ensemble de documents à une machine équipée pour ça.
 SUR LA CHAÎNE · NOUVELLE VIDÉO Parrallels Desktop 27 : 1 code, 3 OS : comment je développe RustMusic sur Mac Voir la vidéo →
Ce qui permet à un GPU de 2013 de suivre
Le projet utilise une version quantifiée du modèle. Dit simplement, les valeurs apprises sont stockées avec moins de précision que dans une version plus lourde. Selon les chiffres publiés, la version employée descend autour de 4,5 Gio pour le modèle de langage lui-même. La taille du paquet complet est supérieure, car il embarque aussi les autres modèles et les éléments de l’application.
Le moteur exploite aussi la capacité du modèle à proposer plusieurs fragments de réponse à l’avance, avant de les vérifier. Lorsque les propositions sont bonnes, cela accélère l’affichage. En mode vocal, les ressources nécessaires à la voix réduisent la place disponible pour cette accélération : le débit baisse. C’est ce que je trouve le plus instructif dans le projet. Le résultat tient moins à un chiffre brut de puissance qu’à la façon dont le développeur répartit la mémoire et le calcul selon l’usage.
La console peut produire des réponses fausses comme n’importe quel modèle local de cette taille. Elle ne devient pas non plus aussi souple qu’un PC récent pour changer de modèle ou augmenter le contexte. Elle prouve en revanche qu’une machine construite pour le jeu en 2013 peut encore servir à une tâche complètement différente, à condition d’écrire le logiciel autour de ses contraintes.
À lire aussi
 ARTICLE · 12 NOV. gputaskman : comment voir ce qui remplit la VRAM de ton GPU
 ARTICLE · 1 NOV. GeForce RTX : cet outil sur clé USB débloque certains calculs IA sous Windows
 ARTICLE · 10 NOV. Premiere 27 laisse l’IA trier les rushs, Adobe prépare l’arrivée des agents tiers
 ARTICLE · 4 NOV. Sonos 27.3 : des raccourcis pour la musique, avant l’arrivée de l’IA vocale
 ARTICLE · 8 OCT. Copilot et recherche Windows : ce que Microsoft change avec l’IA hybride
 ARTICLE · 17 MARS Nvidia dévoile le DLSS 5 : le rendu photoréaliste par IA qui divise les joueurs
Commentaires
0