Vous avez déjà un abonnement Gemini, mais vous ne savez plus quel modèle choisir pour relire un dossier ou corriger un projet ? L’arrivée de Gemini 4 Neon ne simplifie pas les noms, mais son positionnement est assez lisible. Annoncé le 18 novembre 2026, il vise les tâches complexes et fréquentes : développement, analyse de documents et travaux réalisés en plusieurs étapes. Google le place entre Carbon, destiné aux projets les plus exigeants, et Hydrogen, pensé pour une exécution plus rapide au quotidien.
Le déploiement concerne notamment les abonnés Google AI Pro et Ultra dans l’application Gemini, ainsi que les développeurs et les entreprises à travers plusieurs outils. Je retiens surtout une promesse à examiner en usage : obtenir un résultat suffisamment approfondi sans payer systématiquement le temps et le coût du plus gros modèle. Cela se vérifie sur un travail réel, pas seulement sur un classement.
Neon cherche sa place entre rapidité et profondeur
Choisir un modèle revient souvent à choisir un compromis. Une réponse courte peut arriver vite tout en laissant de côté une contrainte importante. Un raisonnement plus long peut être pertinent pour un problème difficile, mais disproportionné pour reformuler trois lignes. L’intérêt d’une gamme est de disposer de plusieurs niveaux adaptés à ces situations.
Avec Neon, le cas d’usage à regarder est celui du travail intermédiaire : assez compliqué pour nécessiter de l’analyse, assez courant pour que chaque minute et chaque requête comptent. Un développeur pourrait, par exemple, lui confier l’examen d’un correctif qui touche plusieurs fichiers. Une petite entreprise pourrait lui demander de rapprocher des informations dispersées dans un dossier, en lui imposant un format de restitution précis.
Ces exemples sont des pistes d’évaluation, pas des résultats d’essai. Je préparerais d’abord une tâche dont je connais les difficultés : un cas ambigu, une instruction à ne pas oublier et un résultat que je peux contrôler. C’est une meilleure manière de choisir entre les modèles qu’une conversation de démonstration où tout semble fonctionner.
Le million de tokens demande une précision importante
La fiche du modèle annonce une fenêtre de contexte pouvant atteindre un million de tokens. Il s’agit du volume d’informations que le modèle peut prendre en compte dans une interaction, avec des modalités de sortie propres au service utilisé. Un token est une unité de traitement ; il ne correspond pas systématiquement à un mot, à une ligne ou à une page.
 SUR LA CHAÎNE · NOUVELLE VIDÉO Parrallels Desktop 27 : 1 code, 3 OS : comment je développe RustMusic sur Mac Voir la vidéo →
Il faut surtout distinguer la capacité du modèle de celle de chaque produit qui l’intègre. Dans Antigravity, Google indique un contexte allant jusqu’à 512 000 tokens pour Neon. Présenter le million de tokens comme une limite identique partout serait donc inexact. La sélection du modèle, l’abonnement et l’outil restent des éléments à vérifier ensemble.
Un grand contexte permet de fournir davantage de matière. Il ne dispense pas de préparer cette matière. Dans un dossier volumineux, je donnerais des noms explicites aux documents, une période de référence et une question claire. Une vieille version d’un tableau et sa version corrigée peuvent se contredire ; si leur statut n’est pas indiqué, le problème vient déjà de la demande avant de venir de l’IA.
Une méthode simple consiste à demander une première cartographie : quels documents sont présents, quelles informations manquent et quelles contradictions doivent être tranchées ? Le travail détaillé peut ensuite commencer sur une base plus propre. Cela évite de confondre une réponse longue avec une réponse bien fondée.
Dans Antigravity, un modèle peut organiser le travail d’un autre
Le déploiement d’Antigravity inclut un mode Orchestrator associant Neon et Hydrogen. Le premier organise et vérifie, tandis que le second réalise certaines opérations comme les modifications de code ou les lancements de tests. L’intérêt annoncé est de réserver le raisonnement plus coûteux aux moments où il apporte quelque chose.
Cette répartition rappelle une bonne organisation de projet : on ne demande pas le même niveau d’examen à chaque petite modification, mais on garde une vision d’ensemble. Elle soulève aussi une question très pratique : comment l’utilisateur sait-il ce qui a été modifié et ce qui a réellement été vérifié ? Je privilégierais des comptes rendus qui distinguent les fichiers touchés, les contrôles exécutés et les points encore incertains.
Pour un dépôt logiciel, une consigne utile pourrait préciser le comportement attendu, les contraintes existantes et les vérifications à effectuer. Il faudrait également délimiter les actions autorisées. Examiner une branche et préparer une modification ne sont pas équivalents à déployer un service. Un bon assistant doit permettre de revoir le résultat avant une action qui engage la production.
Le choix d’un orchestrateur ne retire donc pas la responsabilité de définir le but. Si l’objectif est flou, répartir davantage de tâches peut simplement multiplier les mauvaises hypothèses. Je commencerais par un petit changement représentatif avant de lui confier une refonte entière.
Les niveaux de réflexion doivent servir la tâche
Antigravity propose plusieurs niveaux d’effort pour Neon, de Low à Extra, avec High comme valeur par défaut. Le principe est d’ajuster le temps de raisonnement et la dépense de calcul à la difficulté. Cela ne veut pas dire que le réglage maximal améliore chaque demande dans la même proportion.
Pour comparer les niveaux, je garderais la même question et des critères de réussite identiques. Sur un travail de code, on peut regarder si la correction respecte les interfaces existantes et si elle traite le cas qui posait problème. Sur un tableau, on peut contrôler les calculs, les unités et les hypothèses. Le temps total jusqu’au résultat validé compte davantage que le temps de génération seul.
Il est également possible qu’un réglage plus léger soit suffisant pour préparer une étape, puis qu’un réglage approfondi serve à examiner une décision. Cette manière de travailler donne un rôle à chaque niveau. Elle évite de transformer le curseur d’effort en bouton magique censé compenser une question incomplète.
L’API et l’abonnement ne se paient pas de la même façon
Au lancement, les tarifs annoncés pour l’API sont de 3 dollars par million de tokens entrants et de 15 dollars par million de tokens sortants, avec un prix spécifique pour les entrées mises en cache. Ces montants décrivent une consommation technique. Ils ne sont pas le prix de l’abonnement grand public et ne signifient pas qu’un abonné dispose d’une API sans facturation supplémentaire.
À titre d’exemple de calcul, 100 000 tokens d’entrée au tarif normal représenteraient 0,30 dollar. Une sortie de 10 000 tokens représenterait 0,15 dollar. L’ensemble ferait 0,45 dollar pour ces seuls volumes, avant de considérer les autres éléments éventuellement facturés par le service utilisé. C’est un exemple arithmétique, pas une estimation du coût de votre projet.
Le budget réel dépend aussi du nombre de reprises. Une demande répétée dix fois, une réponse inutilement longue ou un dossier renvoyé à chaque étape peuvent compter davantage qu’un écart de tarif entre deux modèles. Je suivrais donc le coût d’une tâche terminée et validée, en conservant un échantillon de demandes représentatives.
Dans les offres avec quotas, la même logique s’applique au temps disponible. Une tâche bien cadrée, dont le résultat peut être vérifié rapidement, vaut souvent mieux qu’une longue session où l’on corrige progressivement des malentendus.
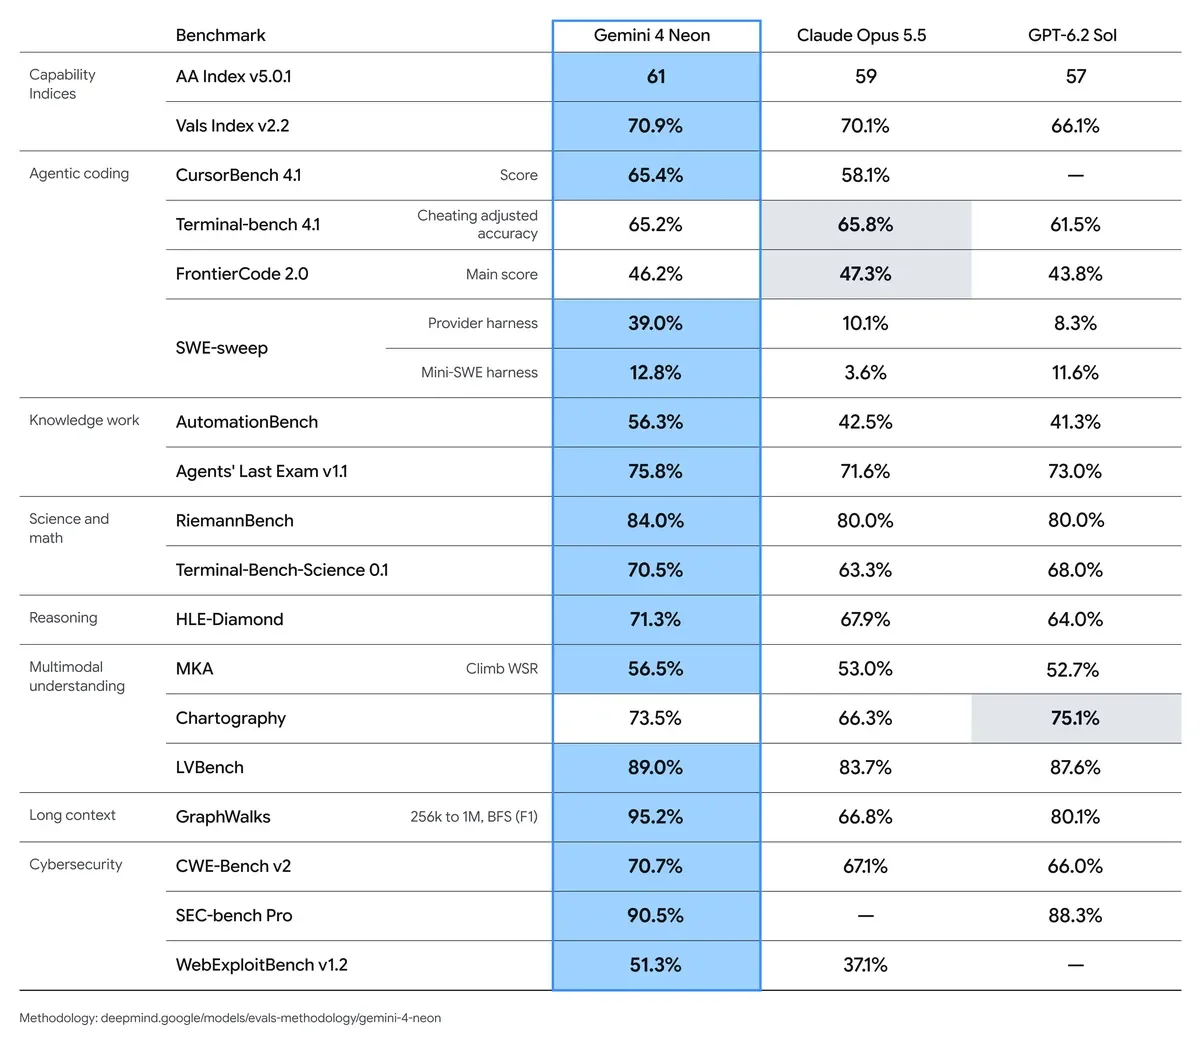
Lire les classements sans leur demander plus qu’ils ne disent
Google accompagne Neon de résultats sur des évaluations de raisonnement et de développement. Ils donnent des indications sur des épreuves précises, réalisées dans des conditions particulières. Ils ne prouvent pas qu’un modèle sera meilleur dans chaque logiciel, dans chaque langue et sur chaque type de document.
Je regarderais aussi le niveau d’effort employé et l’environnement qui entoure le modèle. Un outil capable de rechercher des fichiers, de lancer un programme et de récupérer une erreur n’évalue pas la même chose qu’une fenêtre de discussion sans accès au projet. Une partie de la qualité observée peut venir de cette organisation et des outils disponibles.
Pour un lecteur, la bonne question reste donc très concrète : est-ce que Neon réduit le nombre de corrections nécessaires sur les tâches qui reviennent chez vous ? Un petit tableau de suivi peut suffire, avec la durée, le coût, les erreurs importantes et le résultat final. Il n’est pas nécessaire de fabriquer un laboratoire pour voir si un changement de modèle aide vraiment.
Ce que je vérifierais avant de lui confier un dossier
La fiche de Neon rappelle que des erreurs et des informations inventées restent possibles. Elle indique aussi une date de fin des connaissances d’entraînement en mars 2026. Un modèle lancé en novembre ne possède donc pas automatiquement, dans ses connaissances internes, tous les faits survenus jusqu’au jour de son lancement. La recherche et les documents fournis gardent leur importance pour l’actualité.
Je lui demanderais de distinguer les informations tirées du dossier de ses hypothèses, puis je contrôlerais les éléments qui changent la décision. Pour du code, cela passe par la lecture du correctif et les vérifications pertinentes. Pour un rapport, par le retour aux documents d’origine et aux calculs. Le modèle peut accélérer cette préparation sans devenir une autorité indépendante des pièces qu’il analyse.
Neon mérite donc un essai si vous utilisez déjà Gemini pour des travaux exigeants et répétés. Le bon test n’est pas de lui poser une énigme spectaculaire : donnez-lui une tâche réelle, une limite claire et un résultat à contrôler. Vous saurez alors si sa place entre Carbon et Hydrogen correspond aussi à une place dans votre quotidien.
À lire aussi
 ARTICLE · 14 FÉVR. Bard devient Gemini: L'ère nouvelle de l'IA made by Google
 ARTICLE · 27 FÉVR. Google lance nano banana 2 : la puissance pro à la vitesse flash
 ARTICLE · 12 JANV. Apple et Google, un duo improbable pour transformer Siri avec Gemini : quand l'ennemi juré devient le meilleur allié
 ARTICLE · 31 DÉC. Google Veo 2 : un bond en avant pour l'IA vidéo
 ARTICLE · 13 DÉC. Google présente Gemini 2.0 : ce qu’il faut savoir
 ARTICLE · 7 OCT. Google Photos lance progressivement la fonctionnalité "Ask Photos" alimentée par l'IA
Commentaires
0