Votre GeForce pourrait avoir davantage de ressources à offrir pour certains calculs d’IA. Des projets communautaires regroupés autour de GPU Unlock contournent une limitation du débit de calcul sur plusieurs cartes NVIDIA. Les résultats sont spectaculaires dans certains benchmarks, mais leur signification demande quelques explications : doubler un débit théorique ne revient pas à doubler la vitesse de toutes les applications.
Une limitation ciblée, contournée avant le chargement du pilote
Le projet principal prend la forme d’un module pour le noyau Linux. Il intervient au démarrage, avant que le pilote NVIDIA ne prenne le contrôle de la carte, pour modifier des paramètres qui limitent certaines opérations matricielles. Le pilote habituel est ensuite chargé.
Les calculs concernés utilisent notamment des entrées FP16 ou BF16 avec accumulation en FP32. Derrière ces sigles, il s’agit de formats numériques employés pour exécuter des opérations d’IA. Le déblocage vise leur cadence d’exécution, et ne transforme pas l’ensemble du GPU.
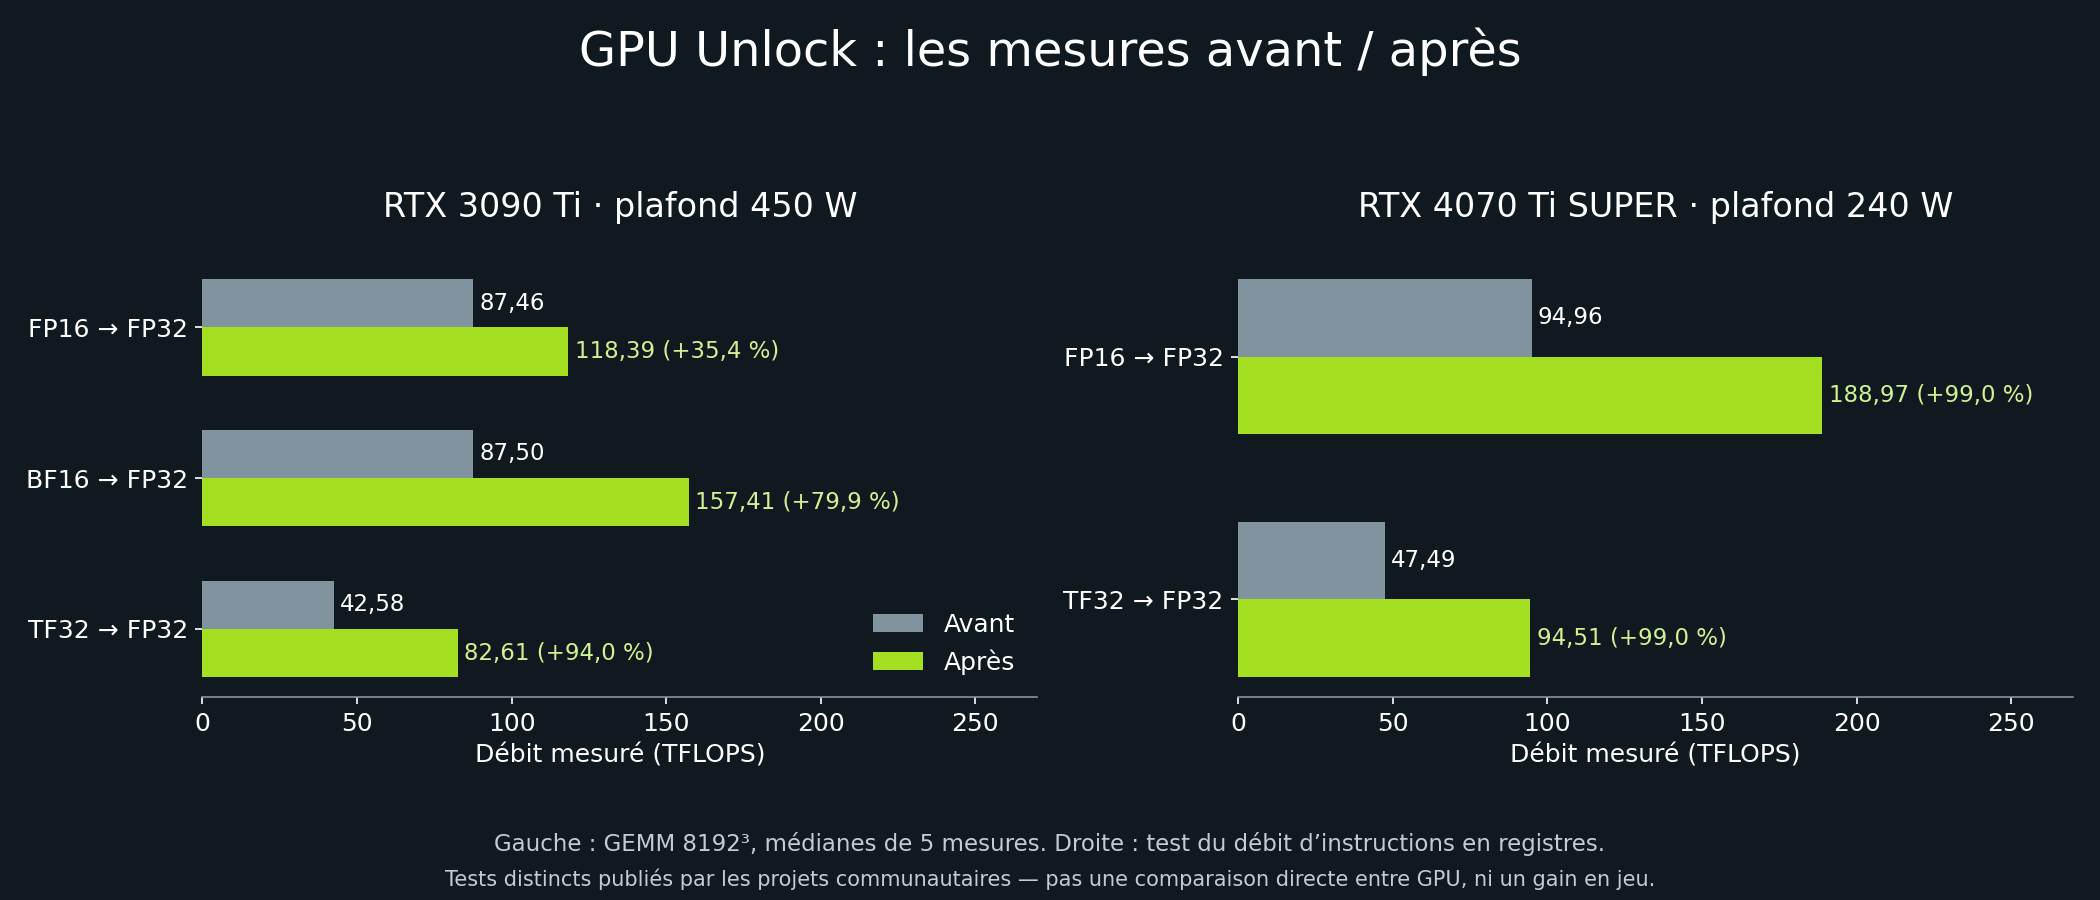
Sur une RTX 3090 Ti testée à 450 W, le projet rapporte par exemple un passage d’environ 87,5 à 157,4 téraflops dans un benchmark matriciel BF16. C’est une mesure précise, dans des conditions données, publiée par la communauté : pas une promesse applicable à chaque logiciel.
Avant et après : les chiffres mesurés
RTX 3090 Ti : multiplication de matrices GEMM 8192³, plafond de puissance de 450 W, médiane de cinq mesures. Les débits sont exprimés en TFLOPS.
| Entrées → accumulation | Avant | Après | Évolution |
|---|---|---|---|
| FP16 → FP32 | 87,46 | 118,39 | +35,4 % |
| BF16 → FP32 | 87,50 | 157,41 | +79,9 % |
| TF32 → FP32 | 42,58 | 82,61 | +94,0 % |
RTX 4070 Ti SUPER : test du débit d’instructions avec données en registres, plafond de 240 W et pilote NVIDIA 580.178.04. Ce protocole diffère du GEMM précédent : les deux cartes ne peuvent pas être classées à partir de ces tableaux.
 SUR LA CHAÎNE · NOUVELLE VIDÉO JBL Charge 3 : NON à l’obsolescence programmée ! je change la batterie et port de charge Voir la vidéo →
| Calcul mesuré | Avant | Après | Évolution |
|---|---|---|---|
| FP16 → FP32 (TFLOPS) | 94,96 | 188,97 | +99,0 % |
| TF32 → FP32 (TFLOPS) | 47,49 | 94,51 | +99,0 % |
| INT4 non signé → INT32 (TOPS) | 754,81 | 754,68 | −0,02 % (stable) |
Sur cette même RTX 4070 Ti SUPER, un autre essai de multiplication de matrices FP8/FP32 avec CUTLASS passe de 59,326 à 59,495 TFLOPS, soit environ +0,3 %. C’est pratiquement inchangé, malgré le doublement observé sur certaines instructions. Ces résultats sont publiés par les projets communautaires ; ils ne proviennent pas d’un test réalisé par La Revue GEEK.
Quelles cartes sont concernées ?
- RTX 30 : plusieurs modèles disposent de retours utilisateurs, notamment les RTX 3090, 3090 Ti, 3080, 3070 et 3060 12 Go. La compatibilité dépend de la variante exacte.
- RTX 40 : une branche dédiée annonce un débit d’instructions FP16/BF16 approximativement doublé sur une RTX 4090. Les résultats dans les applications doivent être distingués de ce test.
- RTX 4070 Ti SUPER : des essais spécifiques existent, mais le support reste expérimental et limité aux configurations documentées.
Une référence présente dans une liste de périphériques ne vaut pas validation sur toutes les cartes vendues sous un nom proche. C’est particulièrement important lorsqu’un résultat ne repose que sur un seul exemplaire.
Pourquoi votre chatbot ne répondra pas forcément deux fois plus vite
Un logiciel passe son temps entre plusieurs tâches : effectuer des calculs, transférer des données, lire la mémoire et coordonner les différentes opérations. Accélérer une seule de ces étapes n’accélère l’ensemble que si elle constituait le principal frein.
Le projet Ada donne un exemple parlant : sur une RTX 4070 Ti SUPER, le débit de certaines instructions progresse fortement, tandis qu’un test matriciel FP8 reste pratiquement inchangé. Les résultats ne se généralisent donc même pas à tous les formats de calcul.
Pour un usage d’IA locale, il faut regarder le temps réellement nécessaire à votre traitement, la justesse du résultat et la stabilité. Un graphique de téraflops ne répond pas à ces trois questions. Il ne dit pas non plus combien d’images par seconde vous gagnerez dans un jeu.
Une découverte intéressante, un déploiement encore expérimental
Je trouve le projet intéressant parce qu’il rend visibles des différences entre les capacités physiques d’une puce et ce que sa configuration autorise. Mais je ne le présenterais pas comme une optimisation à activer machinalement sur son PC principal.
Ce travail communautaire agit très tôt dans l’initialisation du matériel. Les cartes et versions réellement testées, la reproductibilité des mesures et les procédures de retour à une configuration normale comptent davantage qu’un gros pourcentage en titre. Pour l’instant, GPU Unlock mérite surtout d’être suivi comme un chantier technique prometteur.
À lire aussi
 ARTICLE · 21 JUIL. DLSS 5 : Nvidia dévoile trois modèles d’IA capables de changer en temps réel
 ARTICLE · 17 MARS Nvidia dévoile le DLSS 5 : le rendu photoréaliste par IA qui divise les joueurs
 ARTICLE · 10 JUIN Raspberry Pi s'associe à Hailo pour proposer un module AI
 ARTICLE · 26 OCT. Linux 7.4 : les Radeon passent un cap en HDMI 2.1, voici ce qui change
 ARTICLE · 10 JANV. Et si la révolution du CES 2025 était le Project DIGITS de Nvidia ?
 ARTICLE · 5 JANV. Nvidia lance ses pilotes Game Ready 528.02 pour la GeForce RTX 4070 Ti
Commentaires
0