Un serveur web peut être à jour côté application tout en restant exposé par le logiciel qui reçoit ses connexions. C’est le point à vérifier avec l’alerte NGINX du 18 novembre 2026 : deux vulnérabilités liées à HTTP/2 peuvent permettre une exécution de code à distance sans authentification. Les identifiants concernés sont CVE-2026-123007 et CVE-2026-123633. Les versions amont corrigées sont NGINX 1.30.7 et 1.31.9, selon la branche utilisée.
Le CERT-FR signale une preuve de concept publique pour CVE-2026-123007 et recommande de désactiver temporairement HTTP/2 si les correctifs ne peuvent pas être appliqués immédiatement. Je commencerais par identifier où NGINX termine réellement les connexions : le site visible dans le navigateur n’est pas forcément la machine à corriger.
Le risque se trouve à l’entrée du service
NGINX peut servir des fichiers, recevoir des connexions HTTPS ou transmettre les requêtes vers une application située sur une autre machine. Dans une installation, un visiteur peut donc passer par un CDN, un répartiteur, un reverse proxy puis l’application elle-même. Ce parcours explique pourquoi un contrôle limité au serveur qui héberge le code métier peut manquer un composant exposé.
La première des deux failles touche la gestion de la mémoire dans le contrôle de flux HTTP/2. La seconde concerne l’utilisation d’une zone mémoire après sa libération. Ces catégories décrivent des erreurs internes de traitement ; elles ne correspondent pas à un mot de passe faible ou à un compte d’administration mal protégé. Renforcer uniquement l’authentification du site ne corrige donc pas le composant vulnérable.
Une preuve de concept publique démontre qu’un scénario technique a été publié. Elle ne signifie pas, à elle seule, que chaque serveur a été compromis ou qu’une campagne touche toutes les installations. Cette distinction compte : il faut traiter l’exposition rapidement, sans transformer un indicateur de risque en diagnostic d’intrusion déjà établi.
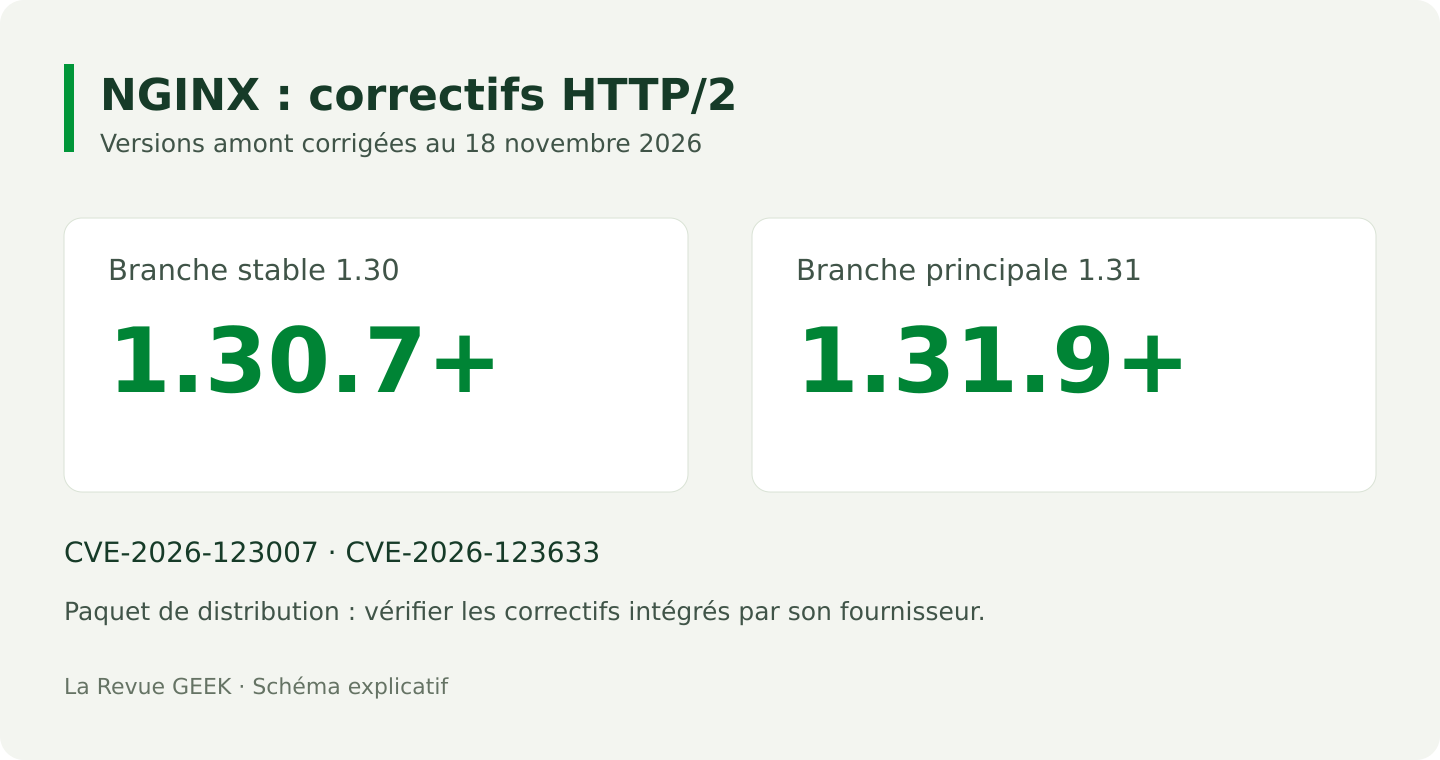
Les versions à vérifier, sans oublier les correctifs des distributions
| Branche amont | Version corrigée | Contrôle à effectuer |
|---|---|---|
| Stable 1.30 | 1.30.7 ou ultérieure | Version du paquet et correctifs fournis |
| Principale 1.31 | 1.31.9 ou ultérieure | Binaire déployé et processus actifs |
La commande nginx -v affiche la version du binaire appelé. Avec nginx -V, on obtient aussi les options de compilation. C’est un point de départ utile pour reconnaître une installation, mais pas un inventaire complet : plusieurs binaires ou plusieurs conteneurs peuvent coexister sur le même hôte.
 SUR LA CHAÎNE · NOUVELLE VIDÉO Parrallels Desktop 27 : 1 code, 3 OS : comment je développe RustMusic sur Mac Voir la vidéo →
Il faut également distinguer le numéro amont du paquet maintenu par une distribution. Un correctif peut être intégré à un paquet sans reprendre le dernier numéro de version publié par le projet. À l’inverse, trouver un nom de paquet rassurant ne prouve rien si le service exécuté provient d’une autre installation. Je rapprocherais donc la version installée du bulletin de sécurité du fournisseur de ce paquet.
Pour NGINX Plus, les références de maintenance ne se lisent pas comme celles de NGINX Open Source. Il faut suivre la branche et le correctif désignés pour le contrat et la version utilisés. Remplacer cette vérification par une comparaison approximative de numéros serait une mauvaise manière de conclure qu’un serveur est protégé.
Un inventaire court vaut mieux qu’une mise à jour au hasard
Dans un petit hébergement, je préparerais une liste avec quatre informations : le composant qui accepte les connexions, sa provenance, son exposition et la personne capable de le mettre à jour. Cette liste permet de distinguer un paquet système, une image de conteneur et un équipement administré par un prestataire.
Un exemple hypothétique : le serveur applicatif utilise un paquet corrigé, mais le reverse proxy de préproduction tourne encore dans une ancienne image. Le site principal est peut-être traité, alors que le sous-domaine de test reste accessible. La bonne question devient alors celle des points d’entrée réellement publiés, y compris ceux qui servent rarement.
Pour les conteneurs, télécharger une nouvelle image ne remplace pas automatiquement les instances déjà lancées. Il faut contrôler le déploiement qui utilise l’image et vérifier ce qui tourne après sa recréation. Dans une infrastructure avec plusieurs nœuds, la même attention doit être portée à chaque instance : une vérification réussie sur un serveur ne décrit pas ses voisins.
Cette démarche peut rester simple. Il n’est pas nécessaire de reconstruire toute la documentation de l’infrastructure avant d’agir. L’objectif immédiat est de savoir quels composants sont concernés, lesquels sont corrigés et lesquels nécessitent encore une mesure provisoire. Une colonne avec la preuve de vérification évite les statuts vagues.
Je noterais aussi les environnements arrêtés mais susceptibles de redémarrer. Une ancienne définition de déploiement peut remettre en service une image dépassée lors d’une restauration. Corriger l’instance visible et actualiser ce qui permet de la recréer sont deux parties du même travail de maintenance.
Désactiver HTTP/2 : une mesure provisoire à adapter à la configuration
HTTP/2 est le protocole utilisé entre deux composants d’une connexion. Le désactiver sur un frontal n’indique pas nécessairement ce qui se passe sur les autres segments. Si un service intermédiaire accepte lui-même HTTP/2, il faut examiner sa configuration propre. Il ne suffit donc pas de modifier un seul fichier parce qu’il appartient au domaine principal.
La syntaxe NGINX dépend de la génération installée. La directive autonome http2, qui accepte on ou off, apparaît à partir de la version 1.25.1. Des configurations plus anciennes activent le protocole dans la directive listen. Copier une ligne prévue pour une autre génération peut produire une erreur ou laisser une activation ailleurs.
Avant une modification, je conserverais la configuration actuelle et j’identifierais les fichiers inclus ainsi que les hôtes virtuels concernés. L’objectif est de couper le protocole sur le point d’entrée à protéger, tout en conservant le service HTTPS nécessaire aux utilisateurs. Les changements de configuration doivent ensuite être contrôlés avant leur prise en compte.
Le contrôle utile : nginx -t vérifie la syntaxe et l’accès aux fichiers référencés. Un résultat valide ne prouve cependant pas que toutes les connexions passent par la configuration attendue. Après application, il faut également vérifier le comportement du service depuis le parcours réellement utilisé par les visiteurs.
Recharger une configuration et remplacer un programme sont deux opérations différentes
Le rechargement de NGINX demande au processus maître de prendre en compte sa configuration et de renouveler ses processus de travail. C’est utile après une modification de paramètres. Une mise à jour du programme pose une autre question : les processus actifs utilisent-ils bien le code corrigé installé sur le disque ?
Je suivrais ici la procédure de maintenance prévue par le système ou le déploiement. Il faut éviter de supposer qu’un simple rechargement remplace toujours tous les éléments exécutés. L’important est le résultat observable : le service reste disponible et les processus qui traitent les connexions utilisent la version attendue.
Sur une plateforme répartie, on peut organiser la maintenance nœud par nœud si l’architecture le permet. Le contrôle doit alors inclure le retour dans le service, la réception de nouvelles requêtes et l’absence d’ancienne instance oubliée. Un mécanisme de supervision qui ne teste qu’une page en cache peut donner une impression de disponibilité sans examiner le composant que l’on vient de modifier.
Je prévoirais également une possibilité de rétablir une configuration fonctionnelle si un réglage casse le site. Cela ne signifie pas remettre durablement une version vulnérable : le retour arrière sert à gérer un incident de déploiement, pendant qu’une solution corrigée est préparée ou qu’une protection provisoire reste en place.
Ce qu’une vérification après intervention devrait montrer
La fin de l’opération doit produire quelques réponses claires. Quel paquet ou quelle image a été installé ? Quels services ont été relancés ou remplacés ? Les points d’entrée prévus répondent-ils ? La configuration provisoire est-elle encore nécessaire ? Ces éléments sont plus utiles qu’une simple capture de la commande de mise à jour.
Les journaux peuvent aider à repérer des redémarrages, des erreurs nouvelles ou un comportement inhabituel. Leur absence ne suffit pas à exclure une intrusion, et une erreur isolée ne suffit pas à en démontrer une. Si des signes concrets de compromission apparaissent, le sujet dépasse la pose d’un correctif : il faut conserver les éléments utiles à l’analyse et examiner les accès concernés.
Il est particulièrement utile de dater les interventions. Si un problème revient, on pourra distinguer une régression de configuration d’une instance qui n’avait jamais été traitée. Pour une équipe, une note courte avec le périmètre, la version et les contrôles exécutés évite de refaire l’enquête quelques jours plus tard.
Le bon réflexe : corriger le point d’entrée, puis confirmer le résultat
Pour un propriétaire de site hébergé chez un prestataire, la demande la plus efficace est précise : quel composant NGINX reçoit les connexions HTTP/2 et quel correctif lui a été appliqué ? Elle permet d’obtenir une réponse vérifiable au lieu d’un simple message indiquant que le serveur est suivi.
Pour un administrateur, je privilégierais la mise à jour adaptée à la branche maintenue, suivie d’un contrôle des instances actives. La désactivation de HTTP/2 reste une option temporaire lorsqu’il n’est pas possible de corriger immédiatement. Elle mérite d’être documentée pour ne pas devenir une modification oubliée dont plus personne ne connaît la raison.
Cette alerte rappelle surtout une règle d’exploitation : la sécurité d’une application dépend aussi des logiciels qui la précèdent. Identifier ce parcours, corriger le bon composant et vérifier le service après intervention apporte une réponse beaucoup plus solide qu’un changement effectué à l’aveugle.
À lire aussi
 ARTICLE · 19 NOV. Windows 11 : les applications pourront conditionner leur accès à la sécurité du PC
 ARTICLE · 3 NOV. WhatsApp vous aide à vérifier un contact inconnu avant de commencer à discuter
 ARTICLE · 30 OCT. Binance victime d'une cyberattaque : 6,3 milliards de dollars seraient concernés
 ARTICLE · 27 OCT. Téléphone volé : couper ses accès à votre compte Google
 ARTICLE · 24 OCT. Quad9 quittera la France le 24 novembre : vérifiez vos réglages DNS avant la coupure
 ARTICLE · 7 OCT. OpenVPN 2.7.8 corrige des failles et fiabilise les connexions VPN
Commentaires
0