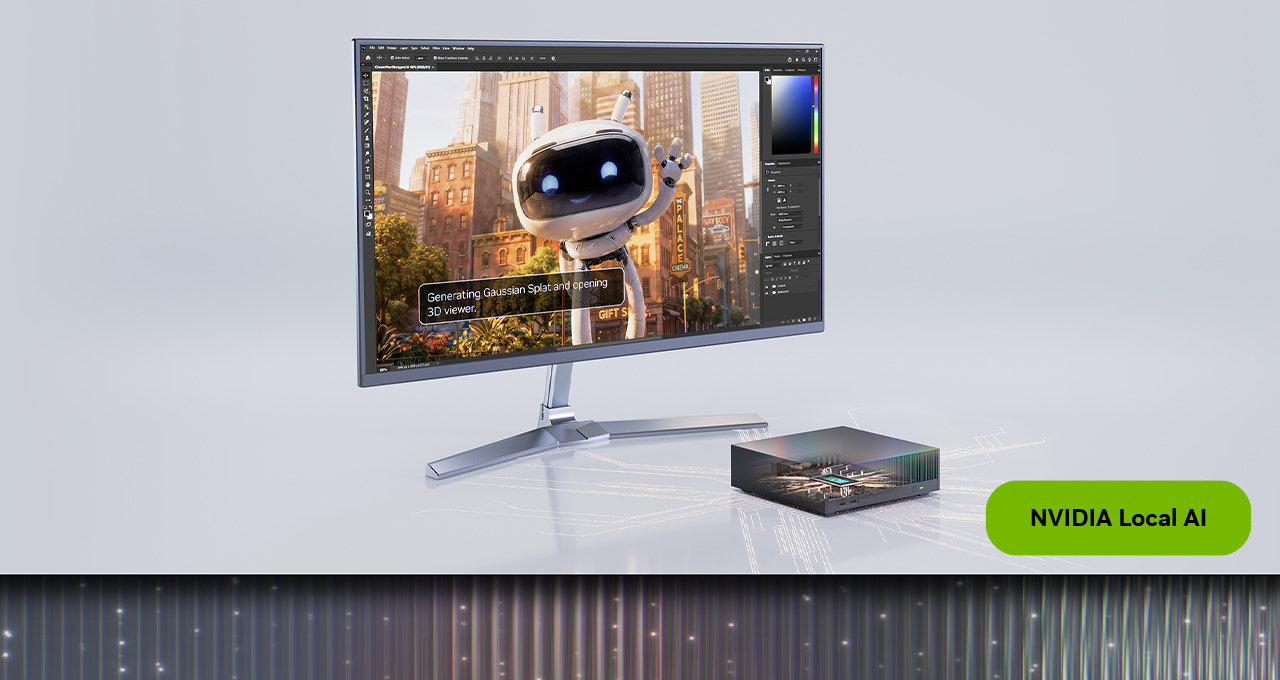
Un assistant qui travaille pendant que le PC principal sert au montage, un modèle de langage qui reste sur le bureau, des images générées sans envoyer chaque demande à un service distant : c’est le terrain choisi par les nouveaux mini-PC NVIDIA RTX Spark. Les premières machines ASUS, Dell et MSI sont annoncées disponibles depuis le 18 novembre 2026. Leur particularité est d’associer une puce Grace sur architecture ARM, un GPU Blackwell et jusqu’à 128 Go de mémoire unifiée dans un ordinateur Windows compact.
Je trouve l’annonce intéressante pour une raison précise : elle remet la capacité mémoire au centre du choix d’un PC pour l’IA. Mais un grand chiffre sur une fiche technique ne suffit pas. Il faut aussi regarder les logiciels réellement compatibles, la vitesse du modèle que l’on veut utiliser et le rôle de cette machine dans son installation.
Un petit ordinateur pensé pour rester au travail
Le scénario visé est celui d’une machine dédiée. Votre portable peut partir dans un sac pendant qu’un ordinateur fixe poursuit un traitement, prépare des documents ou exécute un agent. Cette séparation peut être utile à un développeur, à un créateur ou à une petite structure qui veut expérimenter sans immobiliser sa station habituelle.
Un agent ne désigne pas simplement une fenêtre de discussion. Dans un exemple de travail, il pourrait recevoir un dossier, identifier les fichiers à traiter, lancer les outils autorisés et présenter un résultat à vérifier. L’ordinateur doit alors héberger le modèle, mais aussi ses outils et les données nécessaires. Avant de parler de puissance, je définirais donc le travail attendu : une recherche dans des documents, une génération d’images, une assistance au code ou plusieurs petites tâches indépendantes.
Il faut également prévoir ce qui se passe lorsqu’un traitement échoue. Une machine qui fonctionne seule gagne à disposer de journaux compréhensibles, d’un espace de sortie distinct des fichiers originaux et de règles claires sur les actions autorisées. Le format mini-PC facilite son installation ; il ne remplace pas cette organisation.
Les 128 Go changent surtout ce que l’on peut charger
La plateforme monte jusqu’à un processeur Grace de 20 cœurs et un GPU Blackwell RTX de 6 144 cœurs CUDA. Sa mémoire est partagée entre les différents usages du système. Cette architecture diffère d’un PC qui cumule une mémoire vive classique et une carte graphique possédant sa propre mémoire vidéo.
 SUR LA CHAÎNE · NOUVELLE VIDÉO Parrallels Desktop 27 : 1 code, 3 OS : comment je développe RustMusic sur Mac Voir la vidéo →
| Élément | Ce qui est annoncé | Ce qu’il faut regarder à l’achat |
|---|---|---|
| CPU | NVIDIA Grace, jusqu’à 20 cœurs | Prise en charge ARM des applications |
| GPU | Blackwell RTX, jusqu’à 6 144 cœurs CUDA | Accélération disponible dans votre logiciel |
| Mémoire | Jusqu’à 128 Go unifiés | Capacité de la configuration précise |
| IA | Jusqu’à un pétaflop en FP4 | Débit mesuré avec votre modèle |
Pour donner un ordre de grandeur purement théorique, un modèle de 30 milliards de paramètres représentés sur quatre bits demande environ 15 milliards d’octets pour ses seuls poids. Ce calcul ne comprend ni les métadonnées, ni les structures d’exécution, ni le contexte de la conversation, ni le système. Il explique néanmoins pourquoi la mémoire disponible peut devenir une contrainte avant la puissance brute.
Charger un modèle et l’utiliser confortablement sont deux objectifs différents. Un modèle peut tenir en mémoire tout en répondant trop lentement pour une conversation agréable. À l’inverse, un modèle plus modeste peut suffire à classer des fichiers ou à proposer des résumés. Je choisirais donc la taille du modèle après avoir évalué le résultat utile, plutôt que de prendre le plus gros uniquement parce qu’il entre dans la machine.
Un pétaflop ne donne pas le nombre de réponses par seconde
Le chiffre mis en avant correspond à une puissance de calcul pour un format de très faible précision, le FP4. Il ne décrit pas la vitesse de toutes les opérations d’un ordinateur. Comparer directement cette valeur à celle d’un processeur ou d’une carte graphique mesurés avec un autre format conduirait à une conclusion trompeuse.
Une comparaison utile pourrait utiliser le même modèle, la même quantification, une longueur de contexte identique et les mêmes paramètres. Il faudrait ensuite séparer le temps avant la première réponse de la vitesse de génération. Pour une recherche dans un dossier, la durée de préparation des documents compte aussi. Pour des images, ce seront plutôt la définition, le nombre d’étapes et la méthode de génération.
J’ajouterais deux mesures souvent moins spectaculaires : le bruit pendant une longue charge et la consommation réelle de l’ensemble. Une machine destinée à rester active sur un bureau ne se juge pas seulement sur une démonstration courte. Un ventilateur discret pendant dix minutes peut changer de comportement après plusieurs heures ; seul un essai prolongé permet de le déterminer.
Windows sur ARM : vérifier toute la chaîne de travail
Ces ordinateurs tournent sous Windows sur ARM. Le nom Windows ne garantit donc pas, à lui seul, que chaque programme, extension ou périphérique se comportera comme sur une station x86. L’enjeu dépasse le lancement de l’application principale : un module additionnel, un pilote audio ou un outil de capture peut être le véritable point bloquant.
Pour préparer une migration, je dresserais une liste courte des tâches indispensables et de leurs dépendances. Dans un environnement de développement, cela comprend l’éditeur, les compilateurs, les bibliothèques natives et les outils de déploiement. En création, il faut ajouter les extensions, les formats de fichiers et les matériels utilisés. Cette vérification est bien plus parlante qu’une longue liste de logos compatibles.
NVIDIA met notamment en avant CUDA natif et l’utilisation d’outils Linux à travers Windows Subsystem for Linux. Ce sont deux pistes différentes. Une chaîne Python Windows et une chaîne exécutée dans WSL peuvent avoir des bibliothèques, des chemins et des méthodes d’installation distincts. Je conserverais un environnement de test reproductible pour savoir précisément où le traitement s’exécute et comment le remettre en place.
Le MSI EdgeMesa illustre les compromis du format
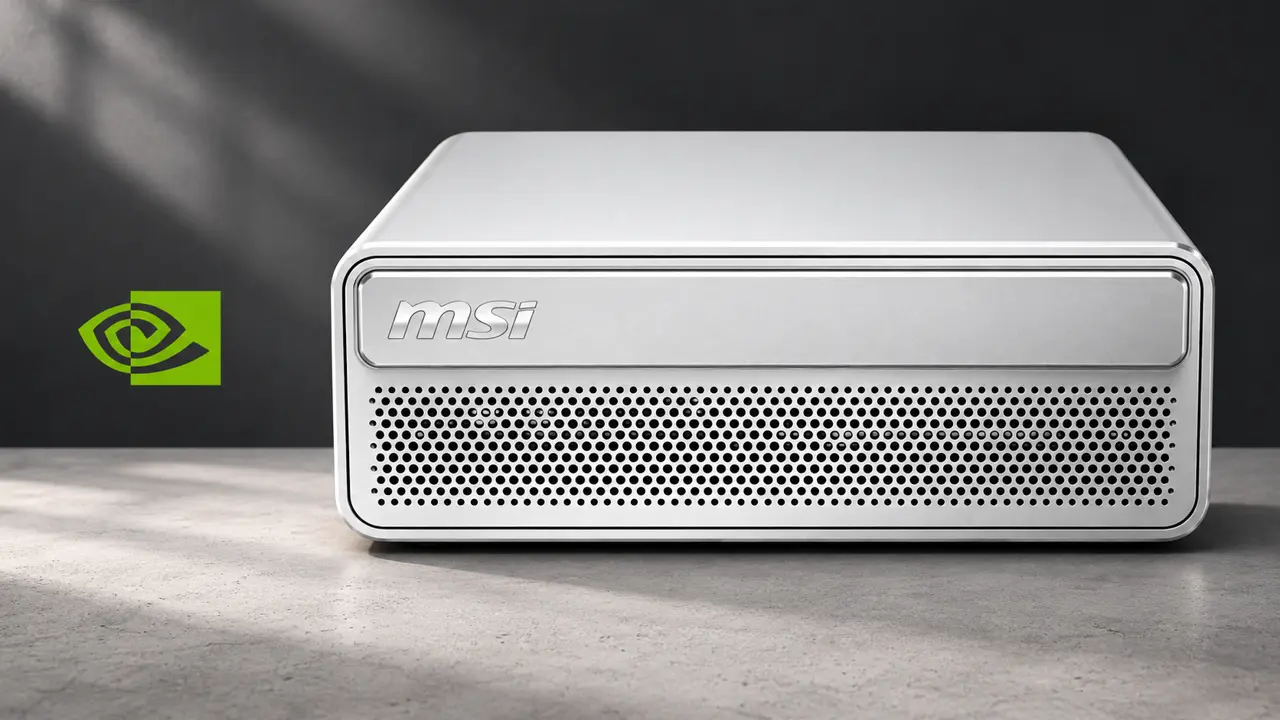
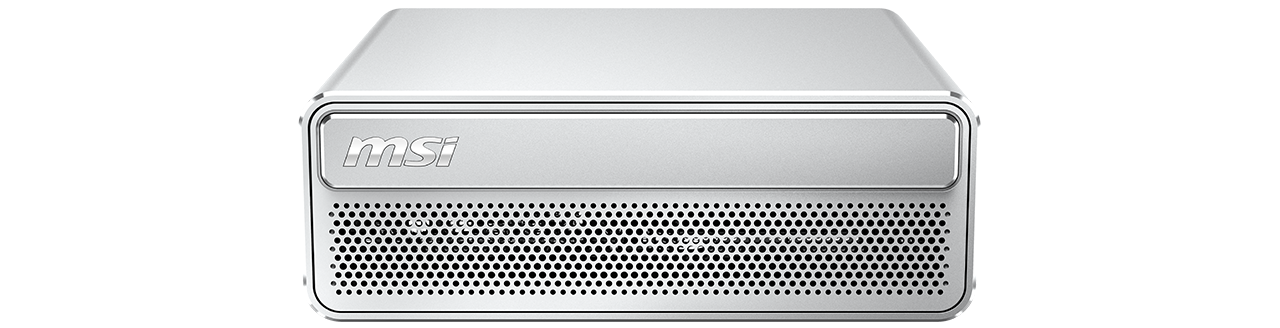
MSI décline la plateforme dans l’EdgeMesa N AI+, avec un boîtier de 1,3 litre et un système de refroidissement associant chambre à vapeur et deux ventilateurs. Le constructeur présente une enveloppe de fonctionnement de 140 W. Ce nombre ne doit pas être confondu avec une consommation constante à la prise : il décrit un objectif de conception de la machine, pas toutes les situations d’usage.
La connectique annoncée comprend du réseau Ethernet 10 Gb/s, du Wi-Fi 7 et des ports USB-C à 20 Gb/s. Un emplacement M.2 NVMe est indiqué pour le stockage. Pour un poste connecté à un NAS, le réseau rapide peut avoir un intérêt concret lors du transfert de jeux de données ou de projets volumineux. Il reste nécessaire que le stockage, les commutateurs et le reste du réseau suivent.
Le petit volume impose aussi une question pratique : quelle place reste-t-il pour faire évoluer la configuration ? Je vérifierais la mémoire choisie au départ, l’accès au SSD, la garantie et les possibilités de maintenance avant l’achat. Il vaut mieux découvrir ces contraintes sur une fiche technique que le jour où le projet dépasse l’espace disponible.
Local ne signifie pas automatiquement isolé du cloud
L’exécution locale permet de traiter certaines données sur sa propre machine. Mais il faut regarder l’ensemble du parcours. Si un agent utilise un service distant pour une partie de sa recherche ou de son raisonnement, les données envoyées à cette étape quittent bien le PC. Le lieu d’hébergement du modèle ne résume donc pas, à lui seul, la confidentialité du travail.
Dans un cas hypothétique de classement de documents internes, je commencerais par limiter l’agent à une copie de travail. Il pourrait lire les fichiers nécessaires et écrire ses propositions dans un dossier séparé. La suppression des originaux, l’envoi d’un message ou une modification de base de données resteraient des actions distinctes. Cette méthode permet d’évaluer la qualité du résultat avant d’élargir les autorisations.
Le calcul économique mérite la même précision. Éviter une facturation à la requête ne rend pas l’opération gratuite : l’ordinateur, son stockage, l’électricité et le temps de maintenance ont un coût. À l’inverse, un service facturé à l’usage peut devenir moins adapté si les traitements sont nombreux et réguliers. Le bon point de comparaison est une charge mensuelle réelle, pas une simple opposition entre abonnement et achat.
À qui cette génération de mini-PC peut rendre service
Je vois surtout un intérêt pour ceux qui ont déjà identifié un besoin mémoire ou un traitement récurrent. Un développeur qui veut expérimenter avec des modèles locaux, un créateur qui utilise une chaîne compatible ou une équipe qui prépare un outil documentaire disposent ici d’une piste cohérente. Le format compact et la mémoire partagée répondent à des contraintes concrètes.
Pour quelqu’un qui cherche uniquement à remplacer un PC de jeu ou à ouvrir quelques applications bureautiques, l’argument est moins évident. Il faut comparer les performances utiles, les compatibilités et le prix de la configuration complète. La disponibilité annoncée par les fabricants ne constitue pas non plus une confirmation de stock pour chaque référence chez un revendeur français.
Mon conseil serait de préparer un petit jeu de tâches avant toute décision : un document représentatif, un projet réel, un modèle précis et un résultat attendu. Les RTX Spark apportent de la capacité dans un format séduisant. Leur valeur se mesurera à ce qu’ils feront de ce travail, régulièrement et sans compliquer le reste de votre installation.
À lire aussi
 ARTICLE · 10 JANV. Et si la révolution du CES 2025 était le Project DIGITS de Nvidia ?
 ARTICLE · 26 OCT. GPU Unlock : des GeForce gagnent en calcul IA, mais les chiffres demandent à être décodés
 ARTICLE · 21 JUIL. DLSS 5 : Nvidia dévoile trois modèles d’IA capables de changer en temps réel
 ARTICLE · 17 MARS Nvidia dévoile le DLSS 5 : le rendu photoréaliste par IA qui divise les joueurs
 ARTICLE · 10 JUIN Raspberry Pi s'associe à Hailo pour proposer un module AI
 ARTICLE · 17 DÉC. Nvidia lance Nemotron 3 : l'offensive open source pour dominer les agents IA
Commentaires
0